Особенности обновления системы с определенных версий
|
При обновлении системы через несколько промежуточных версий необходимо учесть особенности обновления до всех этих версий. Например, при обновлении с версии 2.6.0 до 2.9.0 необходимо учесть особенности обновления с версий:
|
Содержание раздела:
Подготовка к обновлению
Подготовка к обновлению с версии ниже 2.0.0
В системе версии ниже 2.0.0 может возникать ошибка при просмотре логов коллектора в интерфейсе:
Не удалось получить логи коллектора.
connect ECONNREFUSED <...>
В логах пода loki-gateway отображается ошибка:
host not found in resolver "coredns.kube-system.svc.cluster.local." in /etc/nginx/nginx.conf:33
Причина: чарт Loki по умолчанию использует имя coredns для конфигурации разрешения имен пода loki-gateway, однако в кластере может использоваться другое имя для сервиса DNS — например, kube-dns.
В системе версии 2.0.0 и выше данный параметр определяется автоматически, но при обновлении с более старой версии проблема может воспроизводиться, поэтому перед обновлением следует ее устранить.
Решение: нужно исправить конфигурацию сервиса loki-gateway. Для этого:
-
Получите фактическое имя DNS-сервиса:
K8S_DNS_SERVICE="$(kubectl get service -n kube-system -l k8s-app=kube-dns -o 'jsonpath={.items..metadata.name}')" -
Получите конфигурацию
loki-gateway:LOKI_CONFIG="$(get cm loki-gateway -n kube-prometheus-stack -o 'jsonpath={.data.nginx\.conf}')" -
Сравните имена DNS-сервисов:
echo "K8s DNS: $K8S_DNS_SERVICE"
echo "Loki DNS: $(echo "$LOKI_CONFIG" | grep resolver)"
Пример вывода имен DNS-сервисовK8s DNS: kube-dns Loki DNS: resolver coredns.kube-system.svc.cluster.local.;
Если в выводе имена сервисов разные, перейдите к шагу 4.
-
Откройте ConfigMap
loki-gateway:KUBE_EDITOR=nano kubectl edit configmap/loki-gateway -n kube-prometheus-stackЗамените имя DNS-сервиса
corednsпослеresolverна значение переменнойK8S_DNS_SERVICE. После исправления строка ConfigMap должна принять вид:resolver <dns_name>.kube-system.svc.cluster.local.;Здесь:
-
<dns_name>— имя DNS-сервиса Kubernetes, полученное на шаге 3, например,kube-dns.
-
-
Сохраните файл и перезапустите
loki-gateway:kubectl rollout restart deployment/loki-gateway -n kube-prometheus-stack
Подготовка к обновлению с версии ниже 2.3.0
| Начиная с версии 2.3.0 система поставляется на базе платформы R-Vision EVO. |
Выключение коллекторов
Перед обновлением системы с версии ниже 2.3.0 необходимо выключить все работающие коллекторы.
После обновления все необходимые коллекторы и конвейеры нужно будет включить вручную.
Создание общей БД PostgreSQL
Сервисы платформы могут использовать как общую БД, так и собственные. В установщиках системы версий ниже 2.3.0 общая БД отсутствует. Необходимо создать ее вручную с помощью команды:
kubectl exec -n <namespace> sts/postgresql -- psql -U <username> -d postgres -c 'CREATE DATABASE evo;'Здесь:
-
<namespace>— название пространства имен, в котором установлена система. -
<username>— имя пользователя PostgreSQL, которое было указано при установке системы.
|
Имя пользователя PostgreSQL можно получить из секрета Здесь:
|
Обновление NATS
Начиная с версии 2.2.0 в поставку системы входит NATS. При обновлении с 2.2.x необходимо предварительно удалить предыдущие helm-релизы NATS, чтобы избежать ошибок. Для этого:
-
Удостоверьтесь, что NATS развернут в необходимом пространстве имен:
helm list -n <namespace> | grep nats- -
Удалите nats-main и nats-bridge при их наличии:
helm uninstall -n <namespace> nats-bridge
helm uninstall -n <namespace> nats-main
Здесь:
-
<namespace>— название пространства имен, в котором установлена система.
Подготовка к обновлению с версии ниже 2.3.3
Начиная с версии 2.3.3 названия схем активных списков и таблиц обогащения не могут содержать точки.
Перед обновлением системы с версии ниже 2.3.3 удостоверьтесь, что ни одна схема активного списка или таблица обогащения не содержит точки в названии. Если такие схемы или таблицы имеются, необходимо создать их новые версии без точек в названии, а старые версии удалить.
Подготовка к обновлению с версии ниже 2.5.0
Перед обновлением системы с версии ниже 2.5.0 необходимо обновить ClickHouse до поддерживаемой версии.
Подготовка к обновлению с версии ниже 2.6.0
При обновлении системы с версии ниже 2.6.0 настройки стримов в менеджере пространств автоматически принимают значения по умолчанию.
Чтобы не потерять изменения, внесенные в настройки стримов, перед обновлением системы сохраните их в секрет evo.space.global. Для этого выполните следующую команду для каждой измененной переменной окружения:
kubectl patch secret evo.space.global -n evo-namespace -p='{"stringData":{"<env_var>": "<value>"}}'Здесь:
-
<env_var>— переменная окружения, новое значение которой необходимо сохранить. Например:NATS_CONFIGURATOR_GLOBAL_OBJECTS_OS_MAX_SIZE. -
<value>— новое значение переменной окружения. Например:512MB.
|
Список переменных окружения с настройками стримов и их значения по умолчанию приведены в разделе Настройка стримов в менеджере пространств. |
Подготовка к обновлению с версии ниже 2.7.0
При обновлении системы с версии ниже 2.7.0 необходимо обновить ClickHouse до поддерживаемой версии.
Подготовка к обновлению с версии ниже 2.7.1
Пересоздание системных активных списков
Начиная с версии 2.7.1 в активных списках изменена логика срока жизни записей, а также добавлен специальный тип данных для хранения VRL в записях. Теперь срок жизни записи можно задавать в секундах через поле ttl типа integer вместо поля dueDate. Из-за этого при обновлении системы с версии 2.7.0 системные активные списки могут начать работать некорректно.
Чтобы восстановить корректную работу системных активных списков, перед обновлением системы с версии 2.7.0 их необходимо удалить. Для этого:
-
Удостоверьтесь, что системные активные списки не используются ни в одном из конвейеров. В противном случае удалите их из конвейеров.
-
Сбросьте тип системных активных списков на Пользовательский, запустив в СУБД PostgreSQL следующий скрипт:
-- Сброс типа для белого и черного списков.
UPDATE active_list.public.active_list
SET is_system = false
WHERE active_list_name IN ('system-whitelist', 'system-blacklist');

-- Сброс типа для схем белого и черного списков.
UPDATE expertise.public.expertise
SET object_type = 'custom'
WHERE name IN ('system-whitelist', 'system-blacklist');

-- Удаление скрипта добавления исключений.
DELETE FROM evo_streams_script.public.executed_script WHERE name = 'ScriptAddExceptionActiveList';
В представленном скрипте конструкции вида
<db_name>.public.<table_name>интерпретируются следующим образом:-
<db_name>— название БД в PostgreSQL. Примеры из скрипта:active_list,expertise,evo_streams_script. -
public— название схемы в БД. -
<table_name>— название таблицы в БД. Примеры из скрипта:active_list,expertise,executed_script.
-
-
Удалите системные активные списки:
-
Перейдите в раздел Ресурсы → Активные списки.
-
Найдите активные списки system-whitelist и system-blacklist.
-
Удостоверьтесь, что найденные активные списки имеют тип Пользовательский. В противном случае повторите шаг 2 текущей инструкции.
-
Удалите активные списки system-whitelist и system-blacklist.
-
-
Удалите схемы системных активных списков:
-
Перейдите в раздел Экспертиза.
-
Найдите схемы активных списков system-whitelist и system-blacklist.
-
Удостоверьтесь, что найденные схемы активных списков имеют тип создания Пользовательский. В противном случае повторите шаг 2 текущей инструкции.
-
Удалите схемы активных списков system-whitelist и system-blacklist.
-
|
Если вы хотите импортировать в систему CSV-файлы с записями системных активных списков, которые были экспортированы в версии 2.7.0, их необходимо предварительно отредактировать и привести к актуальному формату. Для этого выполните следующие действия:
|
Обновление настроек NATS Object Store
Начиная с версии 2.7.1 в системе исправлена проблема, из-за которой при сбросе метрик в глобальной шине могла очиститься очередь событий.
Теперь в новых коллекторах сброс метрик не будет приводить к очистке очереди в глобальной шине. Однако в существующих коллекторах данная проблема по-прежнему может наблюдаться. Чтобы исправить ее, необходимо изменить настройки объектного хранилища NATS Object Store. Для этого перед обновлением на версию 2.7.1 или выше выполните следующие действия для центрального кластера и каждого кластера сателлита:
-
Подключитесь к терминалу master-узла кластера.
-
Откройте терминал контейнера пода
nats-space-box:kubectl exec -n <namespace> -it deployment/nats-space-box -- shЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Создайте скрипт
script.sh, например, с помощью команды:vi script.shСодержимое скриптаscript.shfilter="<object_id>" data="$(nats obj ls -n r-space-siem-collector-objects | grep "$filter")" set -- $data list="$@" changed=1 while [ $changed -eq 1 ]; do changed=0 new_list="" prev="" for item in $list; do if [ -z "$prev" ]; then prev="$item" continue fi prev_prefix="${prev:0:105}" curr_prefix="${item:0:105}" if [ "$curr_prefix" \< "$prev_prefix" ]; then new_list="$new_list $item" prev="$prev" changed=1 elif [ "$curr_prefix" == "$prev_prefix" ]; then prev_suffix="${prev:105}" curr_suffix="${item:105}" prev_p2=$(echo "$prev_suffix" | cut -d '_' -f2) curr_p2=$(echo "$curr_suffix" | cut -d '_' -f2) if [[ "$prev_p2" =~ ^[0-9]+$ && "$curr_p2" =~ ^[0-9]+$ && "$curr_p2" \< "$prev_p2" ]]; then new_list="$new_list $item" prev="$prev" changed=1 else new_list="$new_list $prev" prev="$item" fi else new_list="$new_list $prev" prev="$item" fi done new_list="$new_list $prev" list="$new_list" done for oldKey in $list; do suffix="${oldKey:105}" p1=$(echo "$suffix" | cut -d'_' -f1) p2=$(echo "$suffix" | cut -d'_' -f2) p3=$(echo "$suffix" | cut -d'_' -f3) if [[ -z "$p1" && "$p2" =~ ^[0-9]+$ ]]; then suffix="" if [[ "$p3" == "mongodb/mongodb.checkpoints.json" ]]; then suffix="/mongodb.checkpoints.json"; fi if [[ "$p3" == "sftp/checkpoints.json" ]]; then suffix="/checkpoints.json" ; fi if [[ "$p3" == "smb/checkpoints.json" ]]; then suffix="/checkpoints.json" ; fi if [[ "$p3" == "database/checkpoints.json" ]]; then suffix="/checkpoints.json" ; fi if [[ "$p3" == "http" ]]; then suffix="/http_checkpoints.json" ; fi if [[ -n "$suffix" ]]; then prefix="${oldKey:0:105}" newKey=$(echo "$prefix""$suffix") oldConnectionId=$(echo "$oldKey" | cut -d'/' -f2) newConnectionId=$(echo "$newKey" | cut -d'/' -f2) echo ">>>>> rename object key in bucket r-space-siem-collector-objects" echo " old key: $oldKey" echo " new key: $newKey" echo " get obj: $(nats object get r-space-siem-collector-objects "$oldKey" -f -O ./tmp.json)" content=$(cat tmp.json) contentIndex=$((${#oldConnectionId}+18)) contentSuffix="${content:$contentIndex}" newContent="{\"connection_id\":\"""$newConnectionId""$contentSuffix" echo "$newContent" > ./tmp_new.json echo " put obj: $(nats object put r-space-siem-collector-objects --name "$newKey" -f ./tmp_new.json)" echo " del obj: $(nats object del r-space-siem-collector-objects "$oldKey" -f)" fi fi doneЗдесь:
-
<object_id>— идентификатор коллектора или конвейера, для которого необходимо изменить настройки NATS Object Store.При необходимости вы можете указать несколько идентификаторов, разделяя их вертикальной чертой. Например:
7f901c19-451f-698e-a5f4-6ea53f074bb6|e7bebc60-41cf-8bf3-68b1-382332a74f57.Вы также можете не указывать идентификаторы, оставив значение пустым. Тогда скрипт отработает для всех коллекторов и конвейеров в кластере.
-
-
Обновите настройки NATS Object Store. Для этого выполните следующие действия для каждого коллектора в кластере:
-
Отключите конфигурации всех конвейеров в коллекторе.
-
Выключите коллектор.
-
Отредактируйте скрипт
script.sh, добавленный ранее, указав идентификатор коллектора вместо<object_id>. -
Запустите скрипт, например, с помощью команды:
sh script.shДля коллектора будут обновлены настройки NATS Object Store.
-
Включите коллектор и установите конфигурации его конвейеров.
Вы также можете обновить настройки сразу всех коллекторов в кластере. Для этого:
-
Отключите конфигурации всех конвейеров во всех коллекторах кластера.
-
Выключите все коллекторы в кластере.
-
Укажите пустое значение вместо
<object_id>в скриптеscript.sh. -
Запустите скрипт, например, с помощью команды:
sh script.sh -
Включите нужные коллекторы и установите конфигурации их конвейеров.
Однако данный вариант не рекомендуется, поскольку при отключении всех коллекторов может произойти большая пауза в сборе событий.
-
После выполнения действий временный скрипт script.sh можно не удалять вручную, поскольку он будет удален автоматически при перезапуске пода.
|
Подготовка к обновлению с версии ниже 2.8.0
Прекращение поддержки прямого обновления с версий ниже 2.3.0
Начиная с версии 2.8.0 прямое обновление системы с версий ниже 2.3.0 не поддерживается. При попытке запуска такого обновления отобразится сообщение о необходимости сначала обновить систему до версии 2.3.0 или выше.
В таком случае следует выполнять обновление в два этапа:
-
С версии ниже 2.3.0 — до 2.7.0 или любой ее патч-версии (2.7.x): например, 2.7.1 или 2.7.2.
-
С версии 2.7.x — до 2.8.0 или выше.
Изменение функций поиска подстрок в элементах экспертизы
Начиная с версии 2.8.0 в следующих VRL-функциях исправлен тип первого аргумента с любого (any) на строку (string):
В связи с этим перед обновлением необходимо обновить элементы экспертизы в соответствии с актуальным синтаксисом данных функций.
Подготовка к обновлению с версии ниже 2.9.0
Начиная с версии 2.9.0 VRL-функция find возвращает null, а не -1, если заданная подстрока не найдена.
В связи с этим перед обновлением необходимо обновить элементы экспертизы в соответствии с актуальным поведением данной функции.
Действия после обновления
Действия после обновления с версии ниже 2.3.0
При обновлении системы с версии ниже 2.3.0 в пользовательских ролях сбрасываются все разрешения. После обновления необходимо заново настроить разрешения ролей.
Действия после обновления с версии ниже 2.4.0
После обновления системы с версии ниже 2.4.0 тип существующих точек входа HTTP Client изменится на HTTP Client_deprecated в связи с их функциональными обновлениями.
Для обновления точек входа HTTP Client:
-
Измените тип существующих точек входа HTTP Client_deprecated в конвейерах на обновленный тип без суффикса _deprecated.
-
Удалите устаревший тип точки входа из таблицы
entry_point_typeв базе данных коллекторов PostgreSQL. Для этого:-
Подключитесь к терминалу master-узла кластера.
-
Подключитесь к PostgreSQL, выполнив следующую команду:
kubectl exec -it -n <namespace> postgresql-0 shЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Подключитесь к базе данных коллекторов:
psql -U postgres -d collector -
Удалите из таблицы
entry_point_typeустаревший тип точки входа:delete from "entry_point_type" where "name" like '%_deprecated';
-
Действия после обновления с версии ниже 2.6.0
Переход на новые точки входа R-Vision Endpoint
Начиная с версии 2.6.0 тип точек входа R-Vision Endpoint заменен на R-Vision Endpoint_deprecated в силу функционального устаревания, а R-Vision EVO Endpoint — на R-Vision Endpoint.
После обновления системы с версии ниже 2.6.0 рекомендуется перейти со старых точек входа R-Vision Endpoint_deprecated на новые — R-Vision Endpoint. Для этого:
-
Удалите агенты R-Vision Endpoint и установите системные агенты согласно инструкции в разделе Переход с агентов R-Vision Endpoint на системные агенты.
-
Измените тип существующих точек входа R-Vision Endpoint_deprecated в конвейерах на обновленный тип без суффикса _deprecated и укажите домен для подключения к шлюзу. Подробности приведены в описании точки входа R-Vision Endpoint.
-
Удалите устаревший тип точки входа из таблицы
entry_point_typeв базе данных коллекторов PostgreSQL. Для этого:-
Подключитесь к терминалу master-узла кластера.
-
Подключитесь к PostgreSQL, выполнив следующую команду:
kubectl exec -it -n <namespace> postgresql-0 shЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Подключитесь к базе данных коллекторов:
psql -U postgres -d collector -
Удалите из таблицы
entry_point_typeустаревший тип точки входа:delete from "entry_point_type" where id = 'f7183617-e756-4fa9-9f59-bd2c2529625c';
-
Включение поиска по нескольким хранилищам событий
Одновременный поиск по нескольким хранилищам, созданным до версии 2.4.0 и в версии 2.4.0 или выше, недоступен. Это связано с переходом на тип данных DateTime64 в служебных полях моделей событий в версии 2.4.0. В таком случае необходимо ограничиться поиском только по тем хранилищам, которые были созданы либо в версии ниже 2.4.0, либо в версии 2.4.0 или выше.
|
Для работы поиска по нескольким хранилищам событий выполните процедуру создания недостающих удаленных (remote) и локальных таблиц хранилищ:
-
Создайте необходимые распределенные таблицы с помощью скрипта, приведенного после заголовка Создать необходимые распределенные таблицы в разделе Настройка существующего кластера ClickHouse. Вы можете выполнить скрипт на любом экземпляре кластера ClickHouse.
-
Подключитесь к терминалу master-узла кластера.
-
Откройте ConfigMap сервиса
evo.streams.event-storage-manager. Для этого выполните следующую команду:kubectl -n <namespace> edit configmap evo.streams-event-storage-manager-envЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Измените значение переменной
EVO_STREAMS_EVENT_STORAGE_MANAGER_RECREATE_EVENT_STORAGESна"true".Пересоздание таблиц хранилищ событий занимает некоторое время. В процессе пересоздания liveness-пробы сервиса
evo.streams.event-storage-managerмогут завершиться с ошибкой, что приведет к циклическому перезапуску этого сервиса. Во избежание такого поведения рекомендуется увеличить интервал между liveness-пробами, выполнив следующие действия:-
Откройте конфигурацию контроллера Deployment
evo.streams.event-storage-manager, выполнив следующую команду:kubectl -n <namespace> edit deployment evo.streams.event-storage-managerЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Скопируйте и сохраните текущие значения параметров в секции
livenessProbe.Пример содержимого секцииlivenessProbelivenessProbe: grpc: port: 3000 service: '' initialDelaySeconds: 10 timeoutSeconds: 3 periodSeconds: 10 successThreshold: 1 failureThreshold: 3 -
Увеличьте значения параметров
timeoutSeconds,periodSecondsиfailureThreshold. -
Сохраните изменения.
После перезапуска сервиса
evo.streams.event-storage-managerрекомендуется восстановить настройки liveness-проб по умолчанию. -
-
Удалите под сервиса
evo.streams.event-storage-manager, выполнив следующую команду:kubectl -n <namespace> delete pods -l app.kubernetes.io/name=evo.streams.event-storage-managerПод будет пересоздан автоматически.
-
Дождитесь, когда под
evo.streams.event-storage-managerперейдет в статусRunning. Инструкция по проверке статуса пода приведена в разделе Просмотр состояния подов кластера. -
Когда под перейдет в статус
Running, перейдите в веб-интерфейс системы и убедитесь, что поиск по хранилищам событий выполняется успешно и события поступают в хранилища. -
Откройте ConfigMap сервиса
evo.streams.event-storage-manager. Для этого выполните следующую команду:kubectl -n <namespace> edit configmap evo.streams-event-storage-manager-envЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
-
Измените значение переменной
EVO_STREAMS_EVENT_STORAGE_MANAGER_RECREATE_EVENT_STORAGESобратно на"false". -
Если вы меняли интервал liveness-проб, восстановите интервал по умолчанию в конфигурации
evo.streams.event-storage-manager. Ее можно открыть, выполнив следующую команду:kubectl -n <namespace> edit deployment evo.streams.event-storage-managerЗдесь:
-
<namespace>— название пространства имен, в котором установлена система.
-
Действия после обновления с версии ниже 2.8.0
После обновления системы с версии ниже 2.8.0 могут наблюдаться повышенное потребление памяти (ОЗУ) на worker-узлах и ошибки при запуске сервиса evo.space.space-manager. Инструкция по устранению этих проблем приведена в разделе Обновление системы: повышенное потребление памяти на worker-узлах.
Действия после обновления с версии ниже 2.9.0
Выпуск нового файла лицензии
| В рамках работ по повышению отказоустойчивости системы в режиме кластеризации был изменен подход к хранению файла лицензии. В связи с этим при обновлении с версии ниже 2.9.0 будет сгенерирован новый идентификатор сервера (Server ID) и активная лицензия перестанет быть валидной. |
После обновления потребуется выпуск файла лицензии для нового Server ID. Чтобы получить новый файл лицензии, обратитесь в службу поддержки по адресу support@rvision.ru.
Переход на новые точки входа WMI
Начиная с версии 2.9.0 в связи с обновлением точек входа WMI прежний тип заменен на WMI (deprecated).
После обновления системы с версии ниже 2.9.0 рекомендуется заменить на конвейерах старые точки входа WMI (deprecated) на новые — WMI (WinRM).
Добавление поля для подписки в хранилище событий аудита
Чтобы в хранилище события аудита появилось поле eventPublishId, используйте один из способов:
-
Если хранилище было создано до версии 2.4.0, добавьте поле в ClickHouse вручную.
-
Если хранилище было создано в версии 2.4.0 или выше:
-
Обновите модель событий в карточке хранилища аудита.
-
Удалите данные в ClickHouse вручную и пересоздайте хранилище.
-
Прочие особенности
Особенности обновления с версии ниже 2.3.0
При обновлении системы установщик выполняет ряд специфичных действий по переносу конфигурационных параметров в платформу.
Если во время обновления системы произошел сбой, выполните следующие действия:
-
Удалите метаданные модулей, которые успели развернуться до сбоя:
kubectl get cm -n <namespace> -o name | grep release-info | xargs -n1 -t kubectl delete -n <namespace> -
Запустите обновление повторно без распаковки дистрибутива:
export PATH=$PATH:/opt/r-vision/common/bin
evoctl instance update -v
Особенности обновления с версии ниже 2.9.0
Уникальность названий хранилищ
Начиная с версии 2.9.0, названия хранилищ событий должны быть уникальными. При обнаружении дубликата система добавляет к названию суффикс вида _1, _2 и так далее.
При этом уже занятые варианты пропускаются, например, если есть несколько хранилищ с названиями storage_name, и хранилище storage_name_1 уже существует, новые названия начинаются со storage_name_2.
Настройка режима развертывания Ingress-ресурсов
| Указанную настройку необходимо выполнить однократно при обновлении системы с версии ниже 2.9.0. При последующих обновлениях будет использован ранее заданный вариант развертывания Ingress-ресурсов и этот этап обновления будет пропущен. |
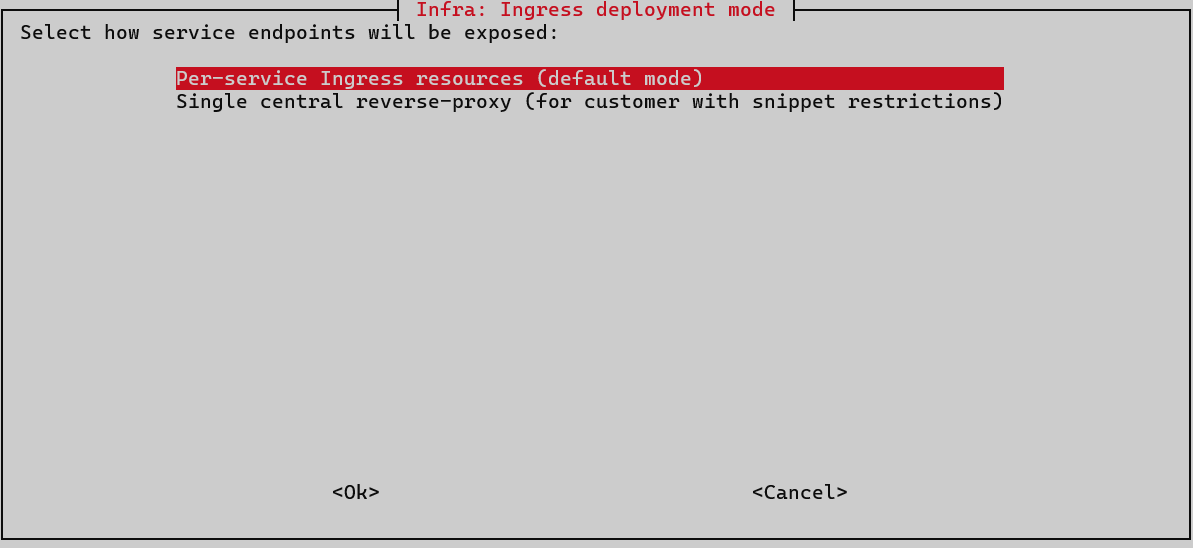
На этапе Ingress deployment mode настройте режим развертывания Ingress-ресурсов для предоставления сетевого доступа к системе:
-
Per-service Ingress resources — будут развернуты отдельные Ingress-ресурсы для каждого сервиса, к которому требуется внешний сетевой доступ. Этот режим рекомендуется для большинства инсталляций.
-
Single central reverse-proxy — отдельные Ingress-ресурсы для сервисов не создаются. Вместо этого развертывается обратный прокси-сервер (reverse proxy) с одним Ingress-ресурсом, который маршрутизирует все запросы к соответствующим сервисам.
Этот режим обязателен для кластера, в Ingress-контроллере которого отключена поддержка сниппетов (snippets).
|
В зависимости от архитектуры кластера Kubernetes установщик может запросить дополнительные параметры развертывания Ingress-ресурсов:
|
Была ли полезна эта страница?


